Arglabs, pelo Claude
Este artigo foi escrito pelo Claude Code (Fable 5.1) em 27/09/2026, a partir do código e da documentação dos 31 repositórios do ARGLabs, e é publicado como foi escrito. Os custos são estimativas a preços de tabela em us-east-1, não faturas.
1. Rodar uma empresa de cloud a partir do git, sem nunca abrir o console
O ARGLabs é uma empresa fictícia com uma AWS Organization real, cinco contas, uma rede compartilhada dual-stack, uma plataforma de containers, bancos de dados, uma CDN e uma camada de controle de custos. Tudo isso vem de 31 repositórios do Bitbucket e é aplicado por pipelines. Ninguém toca no console da AWS. Este documento explica por que a plataforma roda em ECS dentro da conta de cada time, em vez de um cluster Kubernetes compartilhado, quanto o conjunto custa e onde ele está em relação às boas práticas da AWS.
| Número | O que conta |
|---|---|
| 31 | repositórios: 4 raízes de deploy, 4 aplicações, 20 módulos Terraform, 3 ferramentas |
| 5 | contas AWS em 2 unidades organizacionais, além da própria conta de gerenciamento |
| 2 × 2 | regiões e zonas de disponibilidade por ambiente (us-east-1, us-east-2) |
| 13 / 15 | minutos para destruir e para reconstruir dev, stg e prd, medidos em 26/09/2026 |
| 311 | testes automatizados: 245 execuções de teste do Terraform em 11 suítes, 66 testes unitários em Python |
| 0 | chaves de acesso AWS armazenadas, mudanças no console ou NAT gateways |
A empresa em um parágrafo
O ARGLabs tem dois times. O Cloud Team é dono da organização, da identidade, da rede, dos módulos Terraform e das ferramentas. O App Team constrói e opera aplicações sobre isso. A fronteira entre os dois é o desenho inteiro: o Cloud Team entrega código e templates, e cada time roda suas próprias cargas de trabalho nas suas próprias contas AWS. O primeiro (e até agora único) escopo de time se chama All In One, nome curto aio, com uma conta dev, uma stg e uma prd. A região principal é N. Virginia (us-east-1), a segunda é Ohio (us-east-2), e o domínio público é arglabs.org.
Destaques
- Uma conta por ambiente, feita em fábrica. As três contas de um escopo, a ligação de identidade, o DNS, o compartilhamento de rede, o IAM, os clusters ECS, os load balancers, a trilha de auditoria, o orçamento e o dashboard de custos saem de um único repositório (
arglabs-bigbang-aio) que um novo time copia e aponta para o próprio nome. - Uma rede compartilhada, sem NAT. Uma conta do Cloud Team é dona de todas as VPCs e compartilha as sub-redes via AWS RAM. Três camadas, dual stack, uma camada de dados sem rota para a internet e um DNS Firewall. A saída IPv6 é gratuita por meio de um egress-only gateway.
- ECS Fargate em Graviton e Spot atrás de um ALB compartilhado por região, anexado pelo próprio Terraform da aplicação. Nenhum cluster para atualizar, nenhum control plane para pagar.
- Um template de workload com dez recursos liga e desliga (app, secrets, Aurora Serverless v2, Valkey Serverless, SQS, SNS, bucket de logs com Athena, bucket de dados, Lambda, CloudFront), cada um em um único arquivo que pode ser estacionado sem quebrar os outros.
- O Claude Code como portal de autoatendimento. Uma skill
configureentrevista a pessoa desenvolvedora e edita o repositório; uma skillnew-repocria a próxima aplicação a partir do template. - Lord of The Repositories liga e desliga ambientes inteiros na ordem das dependências com um botão. Ele se provou com dois ciclos completos de destruir e reconstruir em uma tarde, com zero pipelines falhando.
- Custo é uma saída de primeira classe. Todo dashboard termina com o custo real do que mostra, todo plan recebe um comentário do Infracost, toda conta tem um orçamento, um monitor de anomalias e o Cost Optimization Hub.
- Varredura de segurança e OIDC em todo pipeline. Checkov, Trivy e Gitleaks rodam a cada mudança; os pipelines pegam um role emprestado por OpenID Connect em vez de guardar chaves.
2. Código primeiro, IA depois
A regra da casa é curta: se roda na AWS, está em um repositório, e um pipeline colocou lá. O dev não recebe nenhuma mudança manual. O stg permite testes manuais, mas tudo o que é feito à mão precisa ser escrito como código, provado no dev, e então o stg é apagado e reconstruído a partir desse código. O prd não recebe mudanças manuais. O console serve para olhar, e até isso raramente é necessário, porque dashboards, tabelas do Athena e uma visão do Resource Explorer são criados pelo mesmo código.
Por que compensa
| Ganho | Onde aparece no ARGLabs |
|---|---|
| Ambientes se tornam descartáveis | A infraestrutura de stg e prd só existe enquanto alguém precisa dela. O lotr reconstrói os três ambientes em cerca de quinze minutos, então mantê-los parados seria desperdício, não rede de segurança. |
| Recuperação de desastre é uma execução de pipeline | Reconstruir a empresa é o mesmo botão que a construiu. Foi exercitado duas vezes em 26/09/2026, e o segundo ciclo não encontrou nada esquecido. |
| Revisão e auditoria de graça | O git diz quem mudou o quê e por quê. A trilha do CloudTrail da organização diz quem chamou qual API, consultável com SQL. |
| Cópias em vez de projetos | Um novo escopo é uma cópia do repositório BigBang com três valores trocados. Uma nova aplicação é uma cópia do template de workload. O Terraform deriva todos os nomes desses valores. |
| Drift é impossível de esconder | Como ninguém edita a AWS à mão, qualquer plan que queira mudar algo que ninguém commitou é um sinal, não ruído. |
| O custo se prende ao código | O provider marca todo recurso com app_name e env, ambas ativas como tags de alocação de custo em toda a organização, então a fatura se lê como os repositórios. |
Onde a IA se encaixa
O Claude Code não é um acessório colado no fim. Os repositórios são escritos para que um modelo possa operá-los com segurança, e isso molda a documentação tanto quanto o código.
- Arquivos CLAUDE.md em camadas. O arquivo do workspace guarda os fatos da empresa (contas, regiões, estrutura de state, regras de nomes, as três formas como os projetos conversam entre si, a política de ambientes). Cada repositório acrescenta seus próprios fatos, pegadinhas e histórico. O Claude os lê antes de tocar em qualquer coisa, e as regras neles sobrepõem os padrões dele.
- O manual é a entrada. Todo arquivo de recurso do workload termina com um bloco
DOCUMENTATION: o que ele cria, o que ligar ou desligar destrói, cada opção com seus valores permitidos e o padrão, o que conferir depois. A skillconfigurelê as opções desse bloco, então o assistente nunca se afasta do código que edita. - Um assistente que entrevista. O
/configurefunciona em qualquer idioma, faz perguntas de múltipla escolha cuja primeira opção é o valor atual, valida pelo caminho (ids de conta de 12 dígitos, regiões reais, pares de CPU e memória do Fargate,min ≤ desired ≤ max), mostra uma tabela de cada mudança e não edita nada até a pessoa dizer sim. Ele também compõe cenários: um site estático, serviços sem app, uma API em Lambda com banco de dados, uma fila processada por uma função, o app atrás de uma CDN com WAF. - Um assistente que cria a estrutura. O
new-repocria o repositório no Bitbucket commaincomo branch padrão e, para uma aplicação, copia para dentro dele omainatual doarglabs-workload. - Limites rígidos. O assistente nunca roda
plan,applyoudestroy(só o pipeline pode), nunca pede valores de secrets, não faz commit dentro do fluxo do configure e pergunta antes de rodar a matriz de validação de 32 minutos. - Operação, não só edição. O exercício de destruir e reconstruir de 26/09/2026 foi conduzido pelo Claude por meio da API do Bitbucket: ele rodou as stacks, inventariou as contas, encontrou log groups órfãos, corrigiu-os em dois módulos e escreveu o relatório.
O resultado é um time de plataforma sem portal. O portal é uma conversa com um modelo que lê o mesmo manual que os engenheiros escreveram, e toda resposta termina como um commit revisado que um pipeline aplica.
3. Decisões de design
ECS na conta do time. Sem EKS.
NOTE: Para a minha opinião (a do humano por trás do ARGLabs) sobre ECS/EKS, veja ECS vs EKS
A decisão mais barulhenta do ARGLabs é uma ausência. Não há Kubernetes em lugar nenhum. As aplicações rodam como serviços ECS no Fargate, na conta AWS do time que é dono delas, ligadas a um load balancer que o BigBang criou para aquele time. O ARGLabs toma uma posição sobre isso: para uma empresa que constrói na AWS, o setup padrão de EKS é obsoleto, técnica e culturalmente.
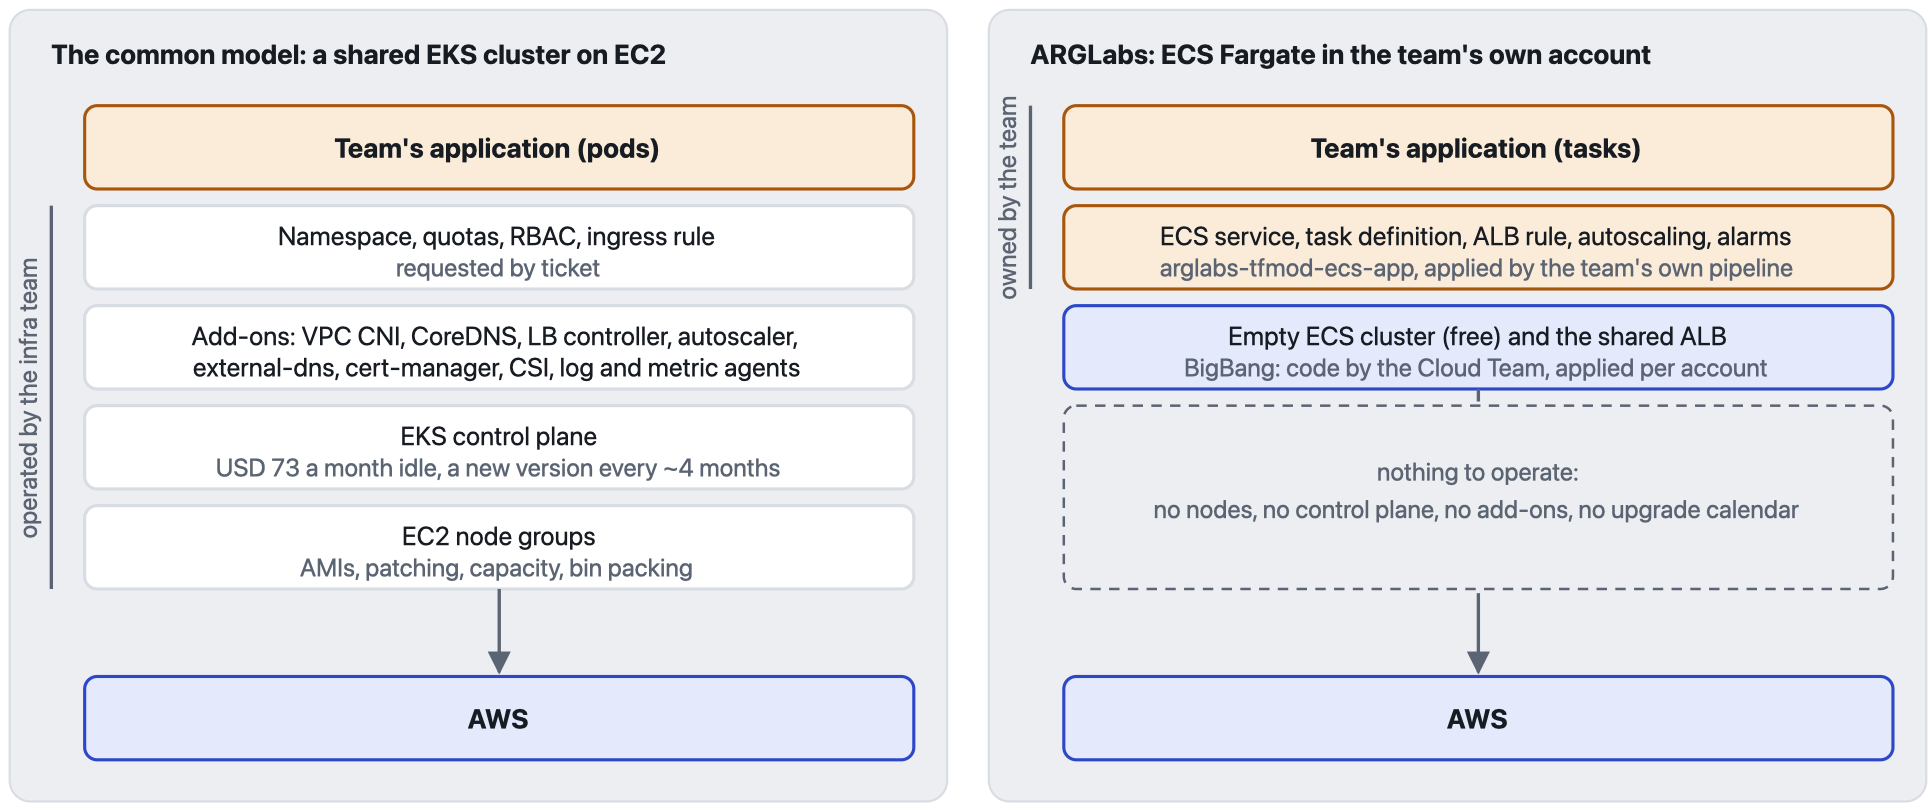
O que fica entre uma aplicação e a AWS. À esquerda, quatro camadas que outro time opera e das quais todo desenvolvedor depende. À direita, uma camada que o time aplica por conta própria e uma que o BigBang provisionou uma vez.
Tecnicamente obsoleto
- O cluster é um produto com calendário de releases. O Kubernetes lança uma versão minor mais ou menos a cada quatro meses e o EKS suporta cada uma por cerca de quatorze. Alguém está sempre preparando a próxima atualização, e um cluster que fica para trás paga USD 0,60 por hora (USD 438 por mês) em suporte estendido em vez de USD 0,10 (USD 73).
- O cluster precisa de uma segunda plataforma por cima para alcançar serviços que a AWS já tem. O VPC CNI com seus problemas de esgotamento de IPs, CoreDNS, kube-proxy, um load balancer controller, um autoscaler, external-dns, cert-manager, um driver CSI de secrets store, agentes de logs e métricas. Cada um tem a própria matriz de versões e os próprios modos de falha.
- Nodes trazem os servidores de volta. AMIs, patching, planejamento de capacidade, bin packing, instâncias reservadas e um node ruim que prejudica todo tenant que está nele.
- ECS é uma API da AWS, não um produto para operar. Não há versão para atualizar, nem cobrança de control plane, e com Fargate nem nodes. Task roles, target groups, CloudWatch, Secrets Manager e X-Ray são nativos, não plugins. No ARGLabs, o cluster que o BigBang cria é um namespace vazio e gratuito; tudo o que importa chega com a aplicação, vindo do
arglabs-tfmod-ecs-app. - Computação mais barata por padrão. As tasks rodam em Graviton arm64. O dev e o stg usam 100% Fargate Spot; o prd mantém duas tasks on-demand por região e divide o resto igualmente.
O que nativo significa na prática. O ECS é um serviço da AWS, então o resto da AWS já sabe como alcançá-lo. Um comportamento que é um projeto no EKS (instalar um controller, dar a ele uma identidade IAM, mantê-lo atualizado) são alguns recursos a mais no Terraform do próprio time no ECS. Dois exemplos primeiro, depois o Spot.
| Você quer | No ECS | No EKS |
|---|---|---|
| Uma task que roda só quando um arquivo cai em um bucket S3 | Uma regra do EventBridge no evento Object Created do bucket, com a task do ECS como alvo. O EventBridge inicia a task e passa a chave do objeto ao container como um override de variável de ambiente. A task termina quando o arquivo é processado. Não há serviço nem capacidade ociosa. | O EventBridge não tem alvo nativo que inicie um pod. O evento passa por outro serviço que alcança o cluster (AWS Batch ou Step Functions), ou por algo que você instala e opera, como uma fila com um KEDA ScaledJob ou Argo Events, mais uma identidade que permita criar o Job. |
| Um worker de fila que escala com o backlog e fica em zero quando a fila está vazia | Service Auto Scaling guiado pela profundidade da fila que o SQS já publica no CloudWatch, com capacidade mínima zero. O serviço adiciona tasks conforme a fila cresce e remove todas quando ela esvazia. Sem nenhuma task rodando, não há computação Fargate para pagar. | O Horizontal Pod Autoscaler não consegue ler o SQS sozinho. O KEDA, ou outro adaptador de métricas, é instalado para alimentá-lo, recebe uma identidade IAM e precisa ser mantido atualizado, e quando o último pod some, um segundo autoscaler ainda precisa remover o node vazio. |
O ARGLabs ainda não tem um módulo para esses dois casos. Cada um é um punhado de recursos no Terraform da própria aplicação.
Spot é uma configuração do serviço, não da máquina. Todo serviço ECS carrega a própria estratégia de capacity provider: uma base, o número de tasks que precisam rodar on-demand, e pesos que dividem tudo acima da base entre Fargate on-demand e Fargate Spot. Um serviço crítico pode exigir dez tasks on-demand e dividir o resto meio a meio com o Spot. Um worker de fila pode rodar 100% em Spot, e o mesmo vale para todo serviço em um ambiente que não seja de produção. No ARGLabs são dois números por serviço, ambiente e região, definidos no Terraform da própria aplicação:
min_ondemand = {
  dev = { us-east-1 = 0, us-east-2 = 0 }
  stg = { us-east-1 = 0, us-east-2 = 0 }
  prd = { us-east-1 = 2, us-east-2 = 2 }
}
spot_weight = {
  dev = { us-east-1 = 100, us-east-2 = 100 }
  stg = { us-east-1 = 100, us-east-2 = 100 }
  prd = { us-east-1 = 50, us-east-2 = 50 }
}
Esses são os valores com que toda aplicação do ARGLabs vem. Tornar um serviço crítico significa aumentar o min_ondemand dele no prd, e nenhum outro serviço percebe.
No EKS o mesmo controle não existe. Os hosts são instâncias EC2, então o Spot é decidido onde as instâncias são compradas: um managed node group é Spot ou on-demand, e um NodePool do Karpenter permite Spot, on-demand ou ambos. Um pod pode se direcionar a um tipo de node com um node selector ou affinity, e a documentação do Karpenter descreve o que chama de método rudimentar para uma proporção fixa: labels em NodePools separados mais uma topology spread constraint em cada Deployment. O que não dá para declarar, por serviço, é “as dez primeiras réplicas on-demand, depois meio a meio”. No EKS Fargate não existe Spot.
Nada disso é o ECS sendo esperto. São recursos da AWS, e o ECS os recebe por fazer parte dela.
Culturalmente obsoleto
- O EKS típico é um cluster grande em EC2, de propriedade de um time de infraestrutura e compartilhado por todos os times de produto. É o datacenter VMware transplantado para a cloud: uma plataforma central, capacidade gerenciada por um grupo, acesso por tickets e uma janela de manutenção que pertence a outra pessoa.
- Nesse modelo, um time de produto não é dono de onde o próprio software roda. Ele pede namespaces, quotas, regras de ingress, tamanhos de node e janelas de atualização. Quando algo quebra, a primeira meia hora vai para decidir se a falha é da aplicação ou do cluster. O time de infraestrutura carrega o risco de todos os times em um único raio de explosão e aprende a dizer não.
- O DevOps não sobrevive ao contato com essa estrutura. Um time não pode ser dono do seu serviço em produção enquanto outro time é dono das máquinas, do plugin de rede e do calendário de atualizações por baixo dele. O velho muro entre desenvolvimento e operações é reconstruído dentro do cluster, e “DevOps” vira o nome do time que guarda o portão.
- O ECS na conta do próprio time remove o runtime compartilhado. O time é dono da conta, do pipeline, do serviço, dos logs, dos alarmes, do orçamento e da fatura. Nada fica entre o time e a AWS. É isso que faz o modelo da seção 4 funcionar, e isso importa mais do que a tabela de preços.
O que se abre mão, de propósito
- Portabilidade pela API do Kubernetes. O artefato portável é a imagem de container, e o ARGLabs a mantém portável: escutar na porta 8080, responder a um health check, escrever linhas JSON no stdout, parar com SIGTERM, rodar em arm64. Essa imagem roda em qualquer orquestrador.
- O catálogo do Helm. Software de terceiros vira um serviço gerenciado (Aurora, ElastiCache, SQS, SNS, CloudFront) ou um container comum, que é como a status page roda o Gatus.
- DaemonSets, operators, schedulers customizados. Nenhum workload aqui precisa deles. Sidecars vivem na task definition.
Uma rede compartilhada sem NAT gateway
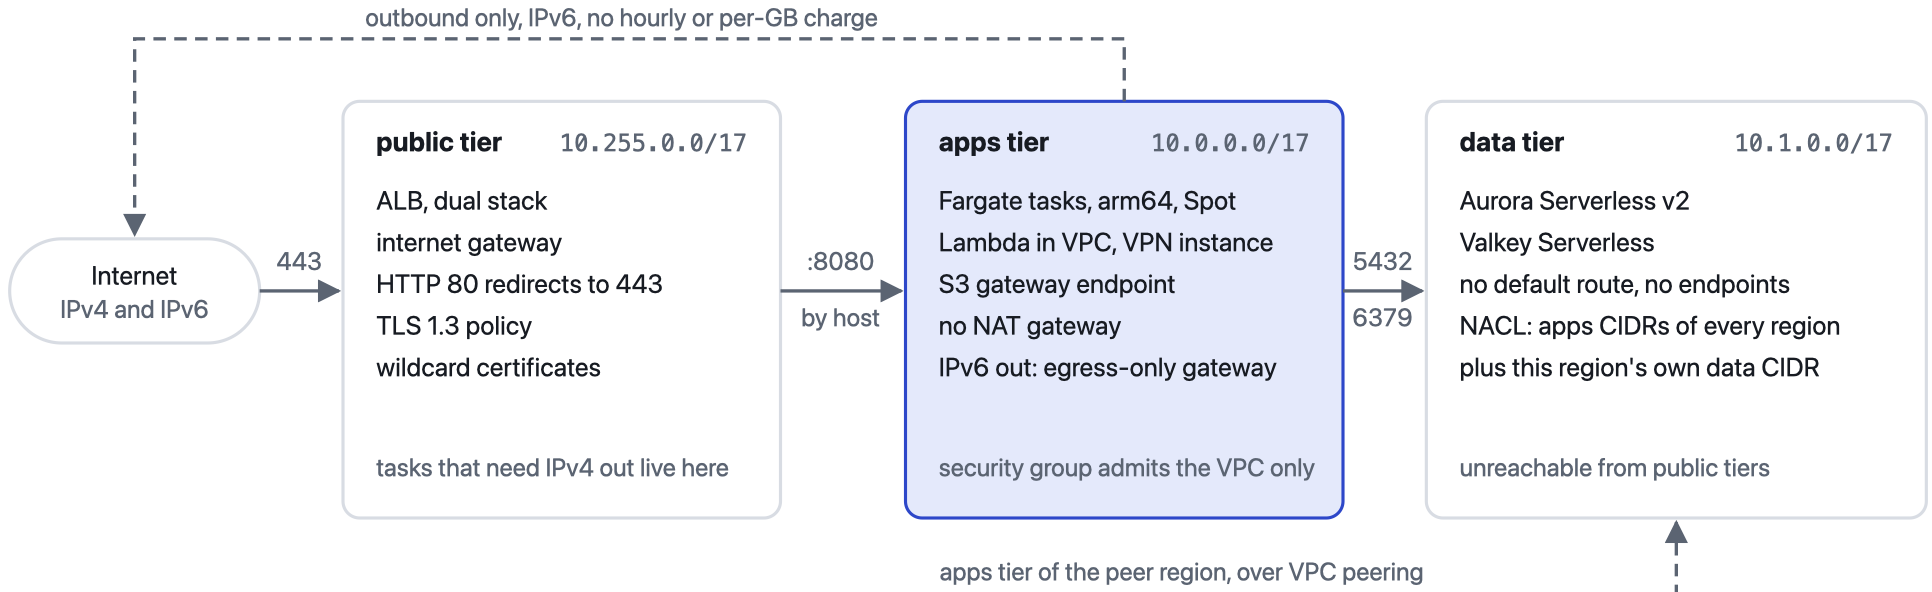
Uma VPC do ambiente dev em us-east-1. A us-east-2 a espelha na metade superior de cada bloco de endereços, e stg e prd repetem o formato nas suas próprias VPCs.
- O Cloud Team é dono de todas as VPCs em uma conta Shared Network dedicada e entrega as sub-redes às contas membro por meio do AWS RAM. As contas dos times não podem criar redes: o role
deployerdelas não tem permissões de VPC além de security groups. - Por ambiente, uma VPC por região (us-east-1 e us-east-2, duas zonas de disponibilidade cada) com um full mesh de peering entre regiões e rotas para o CIDR de cada região parceira.
- A camada de dados é isolada duas vezes. Suas route tables não têm rota padrão nem rota de endpoint, e uma network ACL admite apenas os blocos de apps de todas as regiões mais o próprio bloco de dados. Um endereço da camada pública, mesmo na região parceira, encontra o deny padrão.
- Dual stack em todo lugar. A AWS atribui um /56 por VPC e cada sub-rede recebe um /64. As sub-redes de apps ganham saída IPv6 por um egress-only internet gateway, que não custa nada.
- Sem NAT gateway, por aritmética. Quatro NAT gateways (duas regiões, duas zonas) com seus endereços públicos custariam cerca de USD 146 por mês por ambiente antes de qualquer tráfego. As tasks que precisam de IPv4 de saída (para baixar uma imagem do ECR ou para sondar sites externos) ficam na camada pública com um IP público atrás de um security group que admite só a VPC. A status page e o app de exemplo fazem isso hoje.
- IDs de AZ, não nomes de AZ. As sub-redes são criadas em
use1-az1, nunca emus-east-1a, porque a AWS mapeia nomes para zonas físicas de forma diferente em cada conta e essas sub-redes cruzam contas. - DNS Firewall em toda VPC com a lista agregada de ameaças da AWS, falhando aberto, e um dashboard por escopo. Flow logs, NAT e interface endpoints estão a um booleano de distância no módulo.
Decisões que moldam todo repositório
| Decisão | Motivo |
|---|---|
| Uma conta AWS por ambiente | A fronteira mais dura que a AWS oferece, para raio de explosão, IAM e cobrança. Cada ambiente tem o próprio orçamento, trilha, dashboard de custos e zona DNS. |
| Uma conta de gerenciamento mínima | Só a organização, o Identity Center, o domínio apex, a auditoria da organização e o state do Terraform. Nada roda lá. |
| Identity Center para pessoas, OIDC para pipelines | Administradores são um grupo com AdministratorAccess; o time de cada escopo recebe PowerUserAccess nas próprias contas. Os pipelines trocam um token do Bitbucket por um role e não guardam chaves. |
| Um workspace por ambiente, código idêntico | Valores que diferem vivem em maps indexados por ambiente: { dev = 1, stg = 2, prd = 3 }. Uma branch chamada dev-*, stg-* ou prd-* vira um workspace descartável com nomes próprios. |
Locals em vez de variáveis, nunca .tfvars | As entradas chegam como TF_VAR_* dos arquivos scripts/vars*.sh e são calculadas em locals, onde o Terraform pode fazer aritmética e manipular strings. |
Módulos do git em ref=main, providers mais novos | Todo consumidor pega as correções no próximo plan. A reprodutibilidade é o preço, discutido na seção 7. |
region por recurso no provider v6 | Um provider atende todas as regiões, sem aliases. Uma nova região é uma nova chave no map. |
| Nomes derivados, nunca digitados | <scope>-<app>-<what>-<region short>-<env>, com o ambiente sempre no fim. O código curto da região (use1, apse1) é derivado do nome da região por manipulação de strings e bate com os prefixos dos IDs de AZ. |
| Serviços de dados serverless | Aurora Serverless v2 com auto pause em dev e stg, Valkey Serverless, Lambda, SQS e SNS. Um ambiente ocioso custa pouco além dos seus load balancers. |
| Um arquivo por grupo de recursos, outputs ao lado dos recursos | Um grupo é desligado renomeando seu arquivo para .tf.no (ou movendo-o para available-features/ no workload), e seus outputs somem com ele. |
Políticas com jsonencode | Sem data sources nem templates de política, então uma política se lê como HCL ao lado do recurso que protege. |
| Um módulo nunca escreve uma política que não é dele | O SNS exporta os statements de que uma fila precisa; o CloudFront exporta os statements de que um bucket precisa. O dono do recurso os aplica. |
4. O modelo DevOps
Cloud Engineering e Cloud Platform não operam uma plataforma. Eles escrevem uma, e a entregam como repositórios.
O Cloud Team entrega
- Uma landing zone como código: a organização, a identidade, o domínio apex e a auditoria (
arglabs-mainaccount-orgstuff), a rede compartilhada (arglabs-account-sharednetwork) e um BigBang por escopo que cria as contas do time com tudo dentro delas. - Vinte módulos que codificam as regras: roles sob
/deployer/com um permissions boundary, criptografia por padrão, TLS 1.3, buckets privados, alarmes, dashboards, widgets de custo e tags. A conformidade é a saída padrão do módulo, não uma etapa de revisão. - Um repositório pronto:
arglabs-workload, com uma aplicação de exemplo, dez recursos estacionáveis, o pipeline completo, os scanners, o Infracost, ambientes efêmeros e a skillconfigure. - Ferramentas:
arglabs-lotrpara ligar e desligar ambientes, uma biblioteca de pipelines compartilhada, um hook de pré-commit.
O App Team é dono de
- Seu repositório, criado pelo
new-repoa partir do template. - Seu código em
app/src/, em qualquer linguagem que respeite o contrato da imagem. - Quais recursos estão ligados e suas configurações por ambiente.
- Suas variáveis e secrets, como variáveis
ENV_*eSECRET_*do Bitbucket. - Suas execuções de pipeline, ambientes, alarmes, dashboards e a fatura mensal.
- Seus incidentes, com acesso direto ao CloudWatch, X-Ray, Athena e AWS Support.
Do zero a uma aplicação em deploy
- Peça um repositório ao Claude Code. O
new-repocriaarglabs-<scope>-<app>no Bitbucket a partir domainatual do template. - Rode
/configure, ou descreva o que você precisa com suas próprias palavras. Ele define as contas, o escopo, o nome do app e as regiões, liga ou estaciona recursos, ajusta cada opção e diz o que o próximo apply vai criar e destruir. - Coloque o código em
app/src/, ou deixe o tutorial escrever uma primeira versão na linguagem e no framework que você escolher. - Faça push no
main. O pipeline cria os repositórios ECR, constrói imagens arm64, faz deploy no dev, e então espera um clique antes de planejar, escanear e precificar a mudança, e outro antes do prd. - Para testar de forma isolada, faça push de uma branch
dev-<name>e receba uma cópia privada de toda a stack com nomes DNS próprios. Destrua com um clique, ou deixe o reaper remover todas as cópias de uma vez.
Por que a plataforma é serverless, e por que isso importa
O Cloud Team não opera nada em nome dos times. Não há cluster, nem build farm compartilhada, nem ingress compartilhado, nem catálogo de serviços para manter vivo. A plataforma são repositórios mais serviços gerenciados da AWS, e ela só existe quando um pipeline a aplica. Duas consequências decorrem disso.
Toda capacidade da AWS está disponível desde o primeiro dia. Como o runtime é a própria AWS, um time que precisa de um novo serviço o usa diretamente na própria conta. O trabalho do Cloud Team, no máximo, é adicionar um parâmetro a um módulo para que o Claude dos times possa oferecê-lo como uma pergunta. Nenhuma camada de plataforma precisa aprender a suportar um recurso antes, então o time de plataforma nunca vira a fila onde o trabalho novo espera.
A investigação de problemas vai à fonte. Quando um serviço se comporta mal, o time olha os próprios logs, traces, métricas e custos na própria conta. Ele mesmo pode abrir um caso no AWS Support. Não há cluster para culpar, nem ingress compartilhado para inspecionar, nem ticket para outro time entre o sintoma e a resposta.
O velho acordo era “nós operamos a plataforma, vocês operam o seu código”. O acordo do ARGLabs é “nós escrevemos a plataforma, vocês operam tudo”. Ele escala com o número de repositórios, não com o número de pessoas de plantão.
5. Arquitetura
Contas e unidades organizacionais
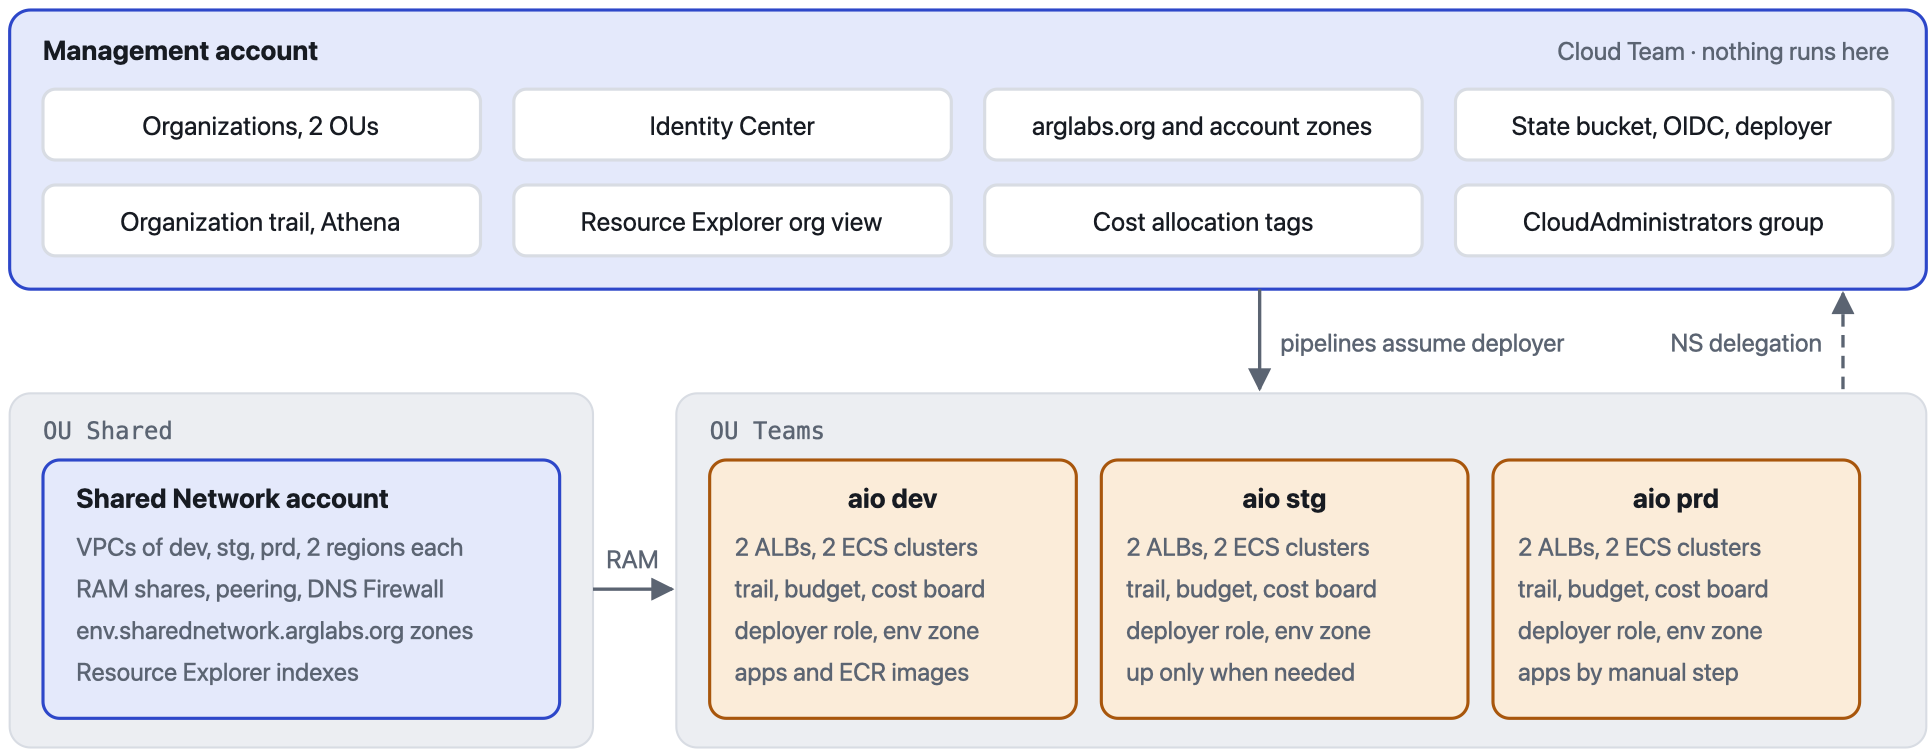
Cinco contas sob uma conta de gerenciamento. O azul é do Cloud Team, o âmbar é do time do escopo. Outro escopo acrescentaria mais três caixas âmbar a partir de uma cópia do arglabs-bigbang-aio .
Fases e dependências
Não há raiz Terraform compartilhada nem service discovery. Toda dependência entre projetos é um de três mecanismos: uma leitura de remote state, um recurso da AWS compartilhado em runtime ou um gatilho de pipeline. O grafo de remote state é a espinha dorsal.
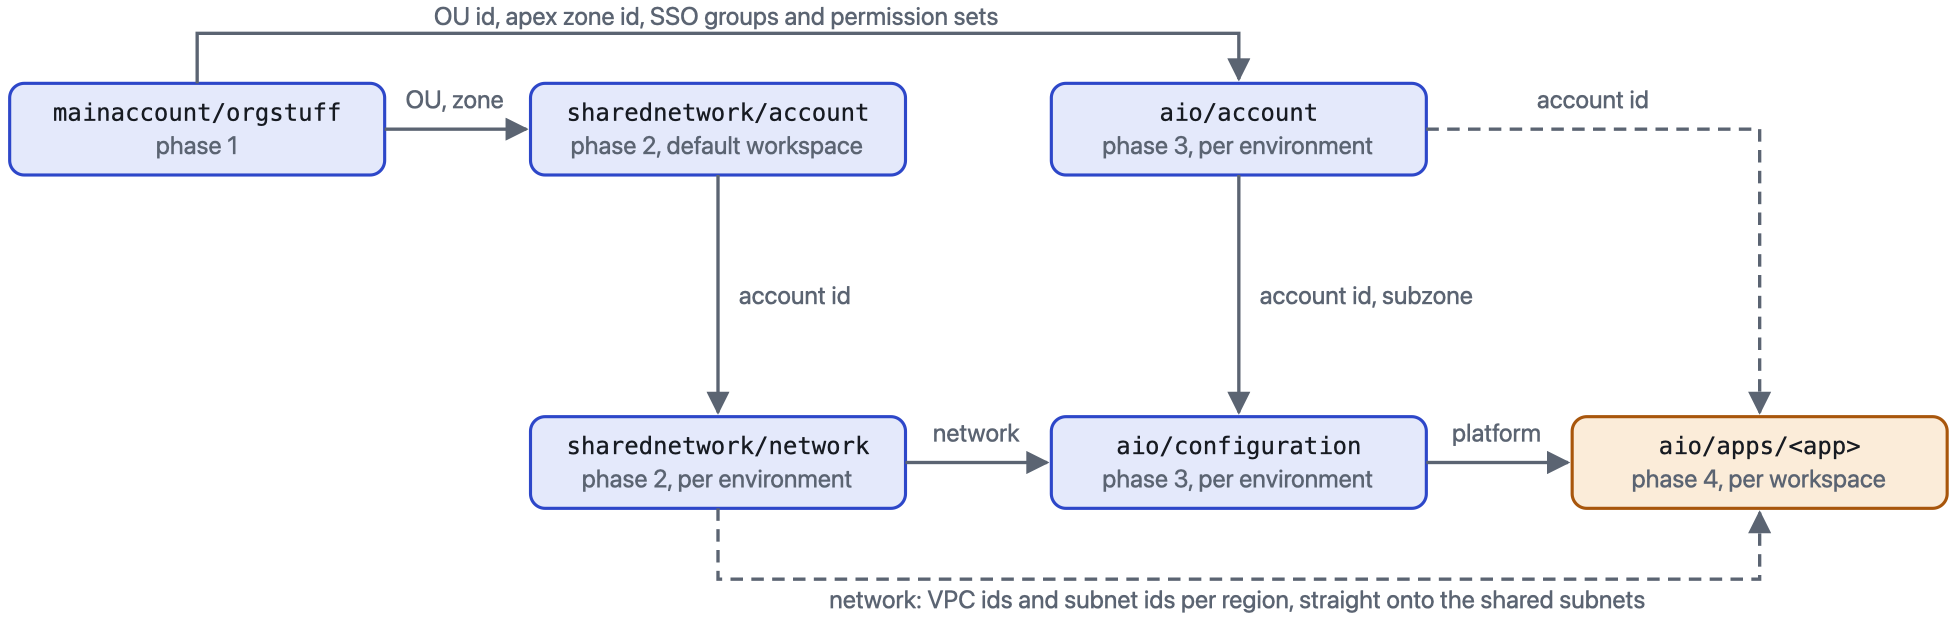
Quem lê quem. Toda leitura passa workspace = terraform.workspace , então o dev só enxerga o dev. Dois outputs funcionam como contratos: network e platform , ambos maps indexados por região.
| Fase | Repositório e raiz | Workspaces | Chave de state | Destruído pelo lotr? |
|---|---|---|---|---|
| 0 | arglabs-mainaccount-prereqs | nenhum, à mão | arquivo local | nunca |
| 1 | arglabs-mainaccount-orgstuff | default | mainaccount/orgstuff.tfstate | nunca |
| 2 | arglabs-account-sharednetwork, criação | default | sharednetwork/account.tfstate | nunca |
| 2 | arglabs-account-sharednetwork, configuração | dev, stg, prd | sharednetwork/network.tfstate | sim |
| 3 | arglabs-bigbang-aio, criação | dev, stg, prd | aio/account.tfstate | nunca |
| 3 | arglabs-bigbang-aio, configuração | dev, stg, prd | aio/configuration.tfstate | sim |
| 4 | cada aplicação, raiz do ECR | só dev | aio/apps/<app>-ecr.tfstate | não (as imagens sobrevivem) |
| 4 | cada aplicação, raiz do app | dev, stg, prd, dev-* e afins | aio/apps/<app>.tfstate | sim |
O Terraform não aceita uma variável na chave de um backend, então toda chave é um literal. O ARGLabs marca cada uma dessas linhas com um comentário âncora (###MARK_STATE_KEY, ###MARK_STATE_ACCOUNT, ###MARK_STATE_CONFIG) e o scripts/change-data.sh reescreve essas linhas a partir do info.sh. Todo workspace, exceto o default embutido do Terraform, é guardado em env:/<workspace>/, então uma chave literal serve dev, stg e prd.
DNS
A zona apex vive na conta de gerenciamento. Cada conta recebe uma subzona, delegada para cima por um módulo que traz o próprio provider e assume o deployer na conta de gerenciamento. Cada ambiente recebe ainda uma subzona na própria conta. As aplicações escrevem registros apenas na zona do ambiente que possuem, e um nome sem região distribui o tráfego pelas regiões que existem.
arglabs.org                        management account, registered domain
├── aio.arglabs.org                management account, created by bigbang-aio (dev workspace)
│   ├── dev.aio.arglabs.org        aio dev account, created by arglabs-tfmod-bigbang
│   │   ├── external-alb-use1      A + AAAA alias to the shared ALB of us-east-1
│   │   ├── external-alb-use2      the same for us-east-2
│   │   ├── statuspage-use1        the status page in us-east-1
│   │   ├── workload               weighted, health-checked, spans every region of the app
│   │   ├── workload-use1          the app in us-east-1
│   │   ├── workload-db            the Aurora writer, when tfmod-rds is on
│   │   ├── workload-cache         latency-routed to the region's Valkey cache
│   │   └── workload-cdn           the CloudFront distribution, when tfmod-cloudfront is on
│   ├── stg.aio.arglabs.org        aio stg account
│   └── prd.aio.arglabs.org        aio prd account
└── sharednetwork.arglabs.org      management account
    └── dev.sharednetwork.arglabs.org   Shared Network account (and stg, prd)
Identidade e confiança
- Um passo de pipeline marcado com
oidc: truerecebe um token de curta duração do Bitbucket. A conta de gerenciamento confia apenas em tokens do workspacearglabs, pela audience. - O passo o troca pelo role
bitbucket-openid, cuja única permissão ésts:AssumeRoleem qualquer role chamadodeployer. Ele também lê e escreve diretamente no bucket de state, e por isso nenhum backend defineassume_role. - O provider da AWS assume o
deployerna conta de destino. Nas contas membro esse role vem doarglabs-tfmod-bigbang-iam: ele confia nobitbucket-openide nos administradores SSO da conta, não pode criar usuários nem grupos, não pode mexer em redes além de security groups e só pode gerenciar roles sob o caminho/deployer/que carreguem odeployer-boundary. Ele não pode reescrever oOrganizationAccountAccessRolenem um role de SSO para escalar privilégios. - Os módulos que precisam escrever em outra conta (a delegação de NS, os registros na zona apex, a aceitação do compartilhamento RAM) trazem o próprio provider e assumem um role lá. O Terraform proíbe
countefor_eachnesses módulos, então eles não têm chaveenable_*.
O pipeline de uma aplicação
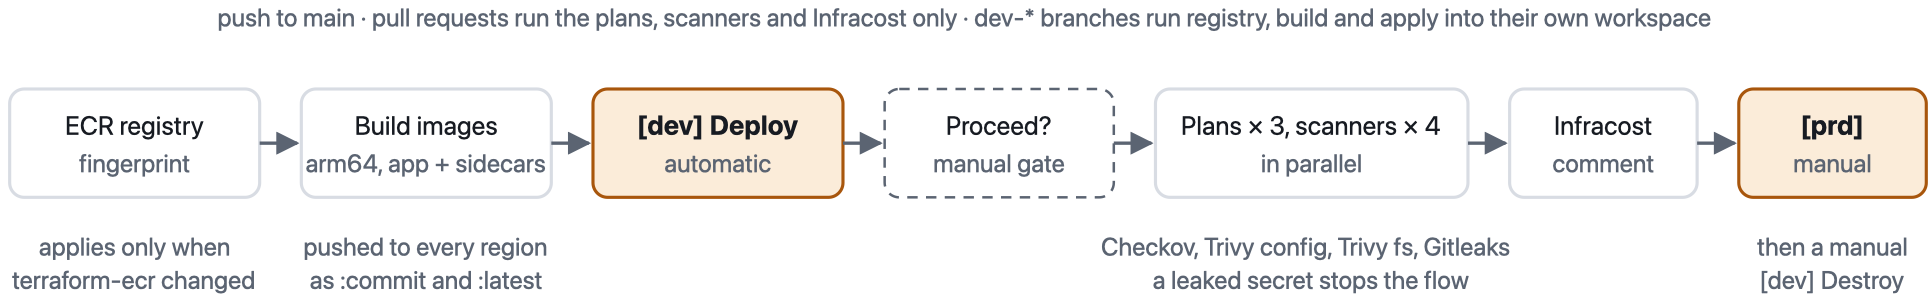
Todo repositório de aplicação roda esse formato. O mesmo wrapper scripts/run-terraform.sh está em todo repositório: ele carrega os arquivos vars*.sh, faz login por OIDC, inicializa o backend, seleciona ou cria o workspace e roda o comando.
- As configurações do container vêm de variáveis do Bitbucket por prefixo.
ENV_LOG_LEVELvira a variável de containerLOG_LEVEL; umSECRET_API_KEYprotegido vai para o Secrets Manager e é injetado comoAPI_KEY. O prefixo é a allowlist, então os tokens do próprio pipeline nunca chegam a uma task. - Os plans são artefatos. O JSON e o texto de cada plan são publicados para o Infracost, que então não precisa de acesso à AWS. O plan binário não é, porque guarda toda variável em texto claro.
- Os achados aceitos são anotados no lugar, com o id da regra e o motivo, nunca em uma lista de ignorados global, exceto o único achado de Dockerfile que o Trivy não consegue receber inline.
- Pipelines customizados cobrem
plan_all,destroy_all,registry,cleanup_parallel_deploymentse os dois hooks do lotr.
6. Quanto custa
Estimativas, não faturas: preços de tabela em us-east-1, tráfego de nível de teste e as contagens de recursos da reconstrução de 26/09/2026. Os números reais vivem no dashboard de custos de cada conta e no comentário do Infracost em cada commit; esta seção explica para onde o dinheiro vai e para onde deliberadamente não vai.
Quatro formas de rodar o ARGLabs
| Cenário | O que inclui | USD / mês |
|---|---|---|
| Tudo desligado | organização, contas, imagens do ECR, snapshots de AMI | 3 a 6 |
| Modo diário | rede e plataforma do dev, status page | 68 a 85 |
| Modo diário + workload de exemplo | app, secrets, bucket de logs em uma região | 83 a 107 |
| Tudo ligado | infraestrutura de dev, stg, prd; apps no dev | 180 a 220 |
USD estimados por mês.
Modo diário, linha a linha
| Componente | O que é cobrado | USD / mês |
|---|---|---|
| Dois ALBs, aio dev | 2 × 16,43 de base, 4 × 3,65 de IPv4 público, algumas horas de LCU | 47 a 50 |
| Trilha da conta, aio dev | segunda cópia dos eventos de gerenciamento a USD 2 por 100.000, mais a ingestão do log group | 2 a 6 |
| Container Insights, enhanced, 2 clusters | métricas customizadas e eventos de log de desempenho | 2 a 5 |
| Dashboards | USD 3 cada além de três por conta: o da status page é o quarto no aio dev | 3 |
| Task da status page | 0,25 vCPU, 0,5 GB, arm64 Spot; um IPv4 público; logs de 5 dias | 6 a 8 |
| Hosted zones | arglabs.org, aio., sharednetwork., dev.aio., dev.sharednetwork. | 2,50 |
| Domínio, armazenamento da trilha, DNS Firewall, chamadas ao Cost Explorer | renovação diluída no ano, S3, USD 0,60 por milhão de consultas, USD 0,01 por requisição de widget | 3 a 8 |
| Total | 68 a 85 |
O que o design se recusa a pagar
Dinheiro que nunca chega à fatura
| Cenário | O que inclui | USD / mês |
|---|---|---|
| Sem NAT gateways | 2 regiões × 2 zonas × 3 ambientes, com seus IPv4 | 438 |
| Sem control planes do EKS | um cluster por ambiente, antes de qualquer node | 219 |
| stg e prd desligados | dois ambientes de plataforma e rede, via lotr | 112 a 134 |
USD estimados por mês, antes de qualquer tráfego.
Some a isso os serviços do ARGLabs que não custam nada: Organizations, Identity Center, Resource Explorer, Budgets, Cost Anomaly Detection, Cost Optimization Hub, certificados ACM, a primeira cópia dos eventos de gerenciamento da trilha da organização, egress-only internet gateways, S3 gateway endpoints e peering dentro da região.
Lendo os números
- Os load balancers são o piso. Dois ALBs com seus quatro endereços públicos são cerca de 60% do modo diário. Um dev de região única, com a us-east-2 reservada para testes de região, economizaria cerca de USD 25 por mês.
- O orçamento fica abaixo do piso. Um orçamento de USD 50 por ambiente contra uma estimativa de USD 55 a 65 significa que o alerta de gasto real provavelmente vai disparar todo mês no dev. Aumente o orçamento ou baixe o piso.
- Os dashboards se somam em silêncio. Todo módulo traz um. Em uma conta com muitos recursos ligados, os dashboards podem custar mais do que a computação.
- O IPv4 público é um imposto sobre cada ponto de entrada: quatro por ambiente nos ALBs, um por task em uma sub-rede pública, USD 3,65 cada.
Preços assumidos
| Item | Preço de tabela de us-east-1 usado |
|---|---|
| Application Load Balancer | USD 0,0225 por hora (16,43 por mês) mais 0,008 por LCU-hora |
| Endereço IPv4 público | USD 0,005 por hora (3,65 por mês) |
| Fargate, Linux, arm64 | USD 0,03238 por vCPU-hora e 0,00356 por GB-hora; Spot cerca de 70% menos |
| NAT gateway | USD 0,045 por hora por gateway ou por zona de um gateway regional, mais 0,045 por GB |
| EKS | USD 0,10 por cluster-hora; 0,60 sob suporte estendido |
| Route 53 | USD 0,50 por hosted zone; health checks a partir de 0,50 |
| CloudWatch | USD 3 por dashboard além de três por conta, 0,10 por alarme, 0,30 por métrica customizada, 0,50 por GB ingerido |
| CloudTrail | primeira cópia dos eventos de gerenciamento grátis; USD 2 por 100.000 eventos para uma segunda cópia |
| Secrets Manager | USD 0,40 por secret, réplicas incluídas |
| Cost Explorer API | USD 0,01 por requisição |
| DNS Firewall | USD 0,60 por milhão de consultas |
| EC2 e EBS | t4g.micro USD 0,0084 por hora, t4g.small 0,0168; gp3 0,08 por GB-mês |
| Aurora Serverless v2 | USD 0,12 por ACU-hora; armazenamento 0,10 por GB-mês |
| Valkey Serverless | cerca de USD 6 por mês no armazenamento mínimo |
7. Avaliação
Veredito: um conjunto bem arquitetado, operado com mais disciplina do que a maioria das empresas consegue em qualquer tamanho. Operações e custos estão à frente da prática comum. As lacunas se concentram em dois lugares: controles preventivos no nível da organização e a proteção do state do Terraform. Ambas são baratas de fechar e nenhuma compromete o design.
Onde segue as orientações da AWS
- Multi-conta com OUs e uma conta de gerenciamento que não roda nada
- Identity Center com grupos e permission sets; nenhum usuário IAM em uso diário
- Federação OIDC para o CI; nenhuma chave de acesso armazenada
- Um deployer de menor privilégio com permissions boundary e caminho de role
- Rede centralizada com compartilhamento via RAM
- Três camadas de sub-redes, uma camada de dados sem caminho para a internet, NACLs como segunda camada
- Dual stack com saída IPv6
- DNS Firewall com listas de ameaças gerenciadas pela AWS
- Uma trilha do CloudTrail da organização com validação de arquivos de log, consultável
- Criptografia por padrão no EBS; SSE em todo bucket; TLS 1.3 na borda
- Secrets no Secrets Manager, injetados na inicialização, nunca no código nem no state
- Varredura de imagens no push; varredura de IaC e de dependências no CI
- Estratégia de tags com tags de alocação de custo ativas
- Budgets, Cost Anomaly Detection, Cost Optimization Hub, Compute Optimizer
- Graviton e Spot; serviços de dados serverless que escalam a zero
- Multi-AZ e multirregião com failover monitorado por health checks
- Tudo como código, em controle de versão, aplicado por pipelines com gates manuais para produção
- Recuperação ensaiada: destruir e reconstruir tudo em minutos
Por pilar
| Pilar | Nota | Pontos fortes | Lacunas |
|---|---|---|---|
| Excelência operacional | Forte | Um formato de pipeline em todo lugar; documentação escrita para pessoas e para a IA; 311 testes automatizados nos módulos; uma reconstrução ensaiada; um CHANGELOG em cada repositório; um hook que formata e documenta no commit. | Refs de módulo flutuantes e sem lock files; states obsoletos e pipelines pausados se acumulam. |
| Segurança | Boa | OIDC, Identity Center, um deployer limitado por boundary, trilha da organização, DNS Firewall, camada de dados isolada, TLS 1.3, criptografia por padrão, varreduras, secrets write-only, monitoramento de leituras de secrets. | Sem SCPs, GuardDuty, Security Hub nem Access Analyzer; Config desligado; um deployer amplo na conta de gerenciamento; logs de auditoria na conta de gerenciamento; secrets em artefatos de plan. |
| Confiabilidade | Boa | Duas zonas e duas regiões; nomes ponderados e monitorados por health checks; opção de banco global do Aurora; autoscaling com uma política de emergência; uma reconstrução de quinze minutos. | Bucket de state sem versionamento nem lock; sem planos do AWS Backup; histórico da status page perdido a cada deploy. |
| Eficiência de desempenho | Boa | Graviton em todo lugar, armazenamentos de dados serverless, roteamento por least-outstanding-requests, nomes de cache roteados por latência, CloudFront sob demanda. | Nada significativo nessa escala. |
| Otimização de custos | Forte | Tags, orçamentos, detecção de anomalias, Cost Optimization Hub, um widget de custo em todo dashboard, Infracost em todo plan, sem NAT, Spot, auto pause, lotr. | O orçamento fica abaixo do piso fixo; dois ALBs em cada ambiente. |
| Sustentabilidade | Forte | Graviton, Spot, ambientes ociosos desligados, serviços que escalam a zero. | Nada significativo. |
Lacunas, as mais importantes primeiro
[Alta] O state do Terraform está desprotegido
O bucket de state tem o versionamento desligado e nenhum backend usa use_lockfile nem uma tabela de lock. Uma escrita ruim ou duas execuções sobrepostas podem corromper um state sem nada para reverter.
Faça: ative o versionamento com um lifecycle para versões antigas; adicione use_lockfile = true a todo bloco de backend.
[Alta] Sem controles preventivos acima das contas
Não há service control policies, e GuardDuty, Security Hub, Access Analyzer e AWS Config estão todos ausentes ou desligados. A segurança depende de cada política IAM estar certa.
Faça: um pequeno conjunto de SCPs (não sair da organização, não parar o CloudTrail, sem usuário root, apenas as duas regiões), GuardDuty e Security Hub com administração delegada, Access Analyzer no nível da organização. Alguns dólares por mês nesse tamanho.
[Média] A conta de gerenciamento carrega demais
O deployer dela tem iam:*, organizations:*, s3:* e sso:*; o usuário IAM de bootstrap ainda existe; o state dele está em um laptop; e o bucket da trilha da organização vive na conta de gerenciamento, onde a AWS recomenda uma conta separada de arquivo de logs.
Faça: desative as chaves de bootstrap entre os usos, mova o state do bootstrap para o bucket, reduza as permissões amplas ao que é gerenciado e crie uma conta de arquivo de logs com o padrão BigBang.
[Média] Módulos e providers flutuam
Todo consumidor busca módulos em ref=main e os providers mais novos, prd incluído. Um push em um módulo muda o próximo plan em todo lugar. Escolhido pela velocidade.
Faça: mantenha main para dev e stacks efêmeras, fixe tags no prd com scripts/change-tfmod-ref.sh e faça commit dos lock files.
[Média] Os artefatos de plan carregam secrets
O JSON do plan publicado inclui toda variável da raiz, as sensíveis também, então os valores SECRET_* ficam legíveis por qualquer pessoa que consiga baixar artefatos. Documentado e aceito hoje.
Faça: remova o bloco variables antes de publicar, ou pare de passar secrets como TF_VAR_*.
[Média] Tasks rodam com IPs públicos
O custo de não ter NAT: as tasks que precisam de IPv4 de saída ficam na camada pública com um endereço público. Os security groups admitem só a VPC, então a exposição é pequena, mas cada endereço custa USD 3,65 por mês e é mais uma coisa a considerar.
Faça: conforme o número de tasks cresce, compare com interface endpoints de ECR, Logs e Secrets Manager (sub-redes privadas, ainda sem NAT), ou com tasks somente IPv6.
[Baixa] O lotr tem pontos cegos
Um repositório ausente do repos.yml pode deixar um security group em uma VPC compartilhada e bloquear a destruição da rede (newapp e a VPN hoje), e duas execuções não podem se sobrepor porque o Bitbucket serializa o deployment de produção.
Faça: liste todo repositório de aplicação e adicione uma verificação pré-destroy de interfaces de rede e security groups alheios nas VPCs compartilhadas.
[Baixa] Orçamento abaixo do piso
USD 50 por ambiente contra uma estimativa de USD 55 a 65 com dois ALBs.
Faça: aumente-o, ou rode o dev em uma região.
[Baixa] Sem logs de rede nem de consultas DNS
As consultas DNS bloqueadas existem só como métricas e não há registro de fluxos. Tudo bem para um laboratório.
Faça: ligue os dois no prd com retenção curta.
[Baixa] Imagens sem versão fixa e caminhos não testados
As imagens base python:alpine e uv não têm versão fixa, os builds enviam latest, as aplicações de stg e prd nunca passaram por deploy de ponta a ponta, e os workspaces efêmeros referenciam um nome de imagem que o build não envia (um bug conhecido).
Faça: fixe as imagens base por digest e rode um deploy completo de stg pelo lotr como ensaio de release.
8. Práticas nascidas aqui
Parte do que o ARGLabs faz é AWS de livro-texto. As ideias abaixo foram construídas aqui, para problemas que o livro-texto não cobre.
Lord of The Repositories
Ambientes de não produção custam dinheiro a cada hora, e um cronograma de desligamento mantido por um time de plataforma nunca serve ao horário de todos os times. O lotr entrega o interruptor ao time. Seu repos.yml declara repositórios e stacks: listas ordenadas de entradas repo:<name>:<pipeline> ou stack:<name>. A ordem escrita é a ordem de execução, então uma stack de apply lista as fundações primeiro e uma stack de destroy as lista por último, à mão, sem inversão automática que possa errar. Cada gatilho é consultado até terminar antes de o próximo começar. on_failure: stop interrompe a execução e marca o resto como ignorado; OVERRIDE_ON_FAILURE o contorna por uma execução. O arquivo inteiro é resolvido e validado antes de qualquer coisa ser disparada: nomes desconhecidos, pipelines ausentes, chaves inválidas e ciclos falham primeiro. O plan imprime a ordem exata sem tocar em nenhum pipeline.
stacks:
  infrastructure-apply-all:
    - repo:sharednetwork:lotr_apply_all
    - repo:bigbang-aio:lotr_apply_all
  applications-apply-dev:
    - repo:workload:lotr_apply_dev
    - repo:statuspage:lotr_apply_dev
  all-destroy-all:
    - stack:applications-destroy-all
    - stack:infrastructure-destroy-all
A evidência. Em 26/09/2026 o lotr rodou dois ciclos completos sobre dev, stg e prd. O all-destroy-all levou 13 min 45 s e 12 min 28 s. A reconstrução levou cerca de 15 minutos em cada vez: a organização em 1 min 16 s, a infraestrutura em 8 a 9,5 minutos (163 recursos de rede e 105 de plataforma por ambiente), as aplicações em cerca de 5. Nenhum pipeline falhou. O exercício também encontrou log groups que a AWS cria por conta própria e que todo destroy anterior havia deixado para trás; agora eles são criados primeiro pelo Terraform, então um destroy sai limpo.
BigBang, a fábrica de contas copiável
Contas, identidade, DNS, compartilhamento de rede, IAM, clusters, load balancers, auditoria e FinOps de um escopo inteiro saem de um repositório e uma chamada de módulo. Um novo time muda três valores e faz push.
Recursos estacionáveis, com prova
Cada recurso do workload é um arquivo que nunca referencia outro. Movê-lo para available-features/ o desliga, e o validate-matrix.sh prova que todas as 1.024 combinações ainda validam, então ligar ou desligar é sempre reversível.
Âncoras onde o Terraform proíbe variáveis
As chaves de backend e de remote state precisam ser literais. As linhas que dependem do escopo carregam um comentário ###MARK_*, e o change-data.sh reescreve exatamente essas a partir do info.sh, de forma idempotente, abortando se uma âncora estiver faltando.
Contratos entre camadas
network, da rede compartilhada, e platform, de cada escopo, são agregados indexados por região. Os consumidores resolvem a região uma vez e leem campos simples, então uma camada pode mudar por dentro sem quebrar quem a lê.
Uma stack completa por branch, e um reaper
Uma branch chamada dev-<anything> faz deploy de uma cópia separada da stack com nomes e DNS próprios. O cleanup_parallel_deployments destrói todo workspace que casa com <env>?* e nunca o verdadeiro.
Documentação que o assistente executa
O bloco DOCUMENTATION no fim de cada arquivo de recurso é ao mesmo tempo o manual e a entrada da skill configure. Com o new-repo, ele substitui um portal de autoatendimento por uma conversa que termina em um commit revisado.
Custo onde os olhos já estão
Todo dashboard que mostra um serviço termina com o custo real desse serviço vindo do Cost Explorer, filtrado por suas tags. Todo o código dos widgets vive em um módulo, então cada número de custo no ARGLabs é calculado do mesmo jeito.
Quem leu o secret
Nenhuma métrica da AWS chega a um único secret, então metric filters na trilha da conta contam as leituras por role, as leituras com falha (com um alarme) e as mudanças, mostradas por região.
Prefixos como allowlist
Apenas as variáveis ENV_* e SECRET_* do Bitbucket chegam a um container. Uma cópia indiscriminada do ambiente teria levado os tokens do próprio pipeline para a produção.
Um app de exemplo que quebra sob demanda
?status=503, ?delay=, ?cpuburn= e ?memburn= deixam qualquer pessoa ver o ALB substituir uma task, o Route 53 retirar uma região ou o autoscaling adicionar tasks a 70%.
Migração de região em três deploys
Adicione a nova região, defina o peso da região antiga como zero no nome sem região, remova a região antiga. Os clientes seguem o nome sem região e nem percebem.
Destroys limpos por propriedade
Tudo o que a AWS criaria sozinha é criado antes pelo Terraform para que um destroy o remova; tudo o que precisa sobreviver a um ambiente (os índices do Resource Explorer, as contas) vive em uma raiz que nunca é destruída.
Pule o que não mudou
A raiz do ECR só é aplicada quando muda uma impressão digital do seu código e das suas entradas, o que poupa uma execução completa do Terraform em quase todo push.
Módulos que nunca escrevem uma política que não é deles
O SNS exporta o que uma fila precisa permitir; o CloudFront exporta o que um bucket precisa permitir. O dono do recurso aplica o statement, então nenhum módulo mexe na política de outro.
9. Roadmap
Na ordem que compra mais segurança com menos trabalho.
- Versione o bucket de state e trave todo backend.
- Adicione SCPs básicas, GuardDuty, Security Hub e Access Analyzer; ligue o módulo Config no prd.
- Crie uma conta de arquivo de logs pelo BigBang e mova para lá o bucket da trilha da organização.
- Fixe tags de módulos e faça commit dos lock files no prd; mantenha
mainpara o dev. - Registre todo repositório de aplicação no
repos.yml, com uma verificação pré-destroy de recursos alheios nas VPCs compartilhadas. - Alinhe o orçamento ao piso, ou rode o dev em uma região.
- Mova os pipelines das aplicações para o
arglabs-cloudteam-sharedpipelines, para que uma correção de pipeline chegue a todos em um commit.
Fontes: os 31 repositórios no main em 27/09/2026 (READMEs, arquivos CLAUDE.md, pipelines, scripts e código Terraform) e o relatório de destruir e reconstruir do lotr de 26/09/2026. Os custos são estimativas a preços de tabela em us-east-1, não faturas.